当贷款决策走进 AI 对话
一家银行的 GEO 实践
从六类需求到品牌与产品问题,从准确的信息表达进入 AI 决策场景:回顾一项从 2025 年 11 月到 2026 年 8 月、按三个阶段推进的银行 GEO 项目。
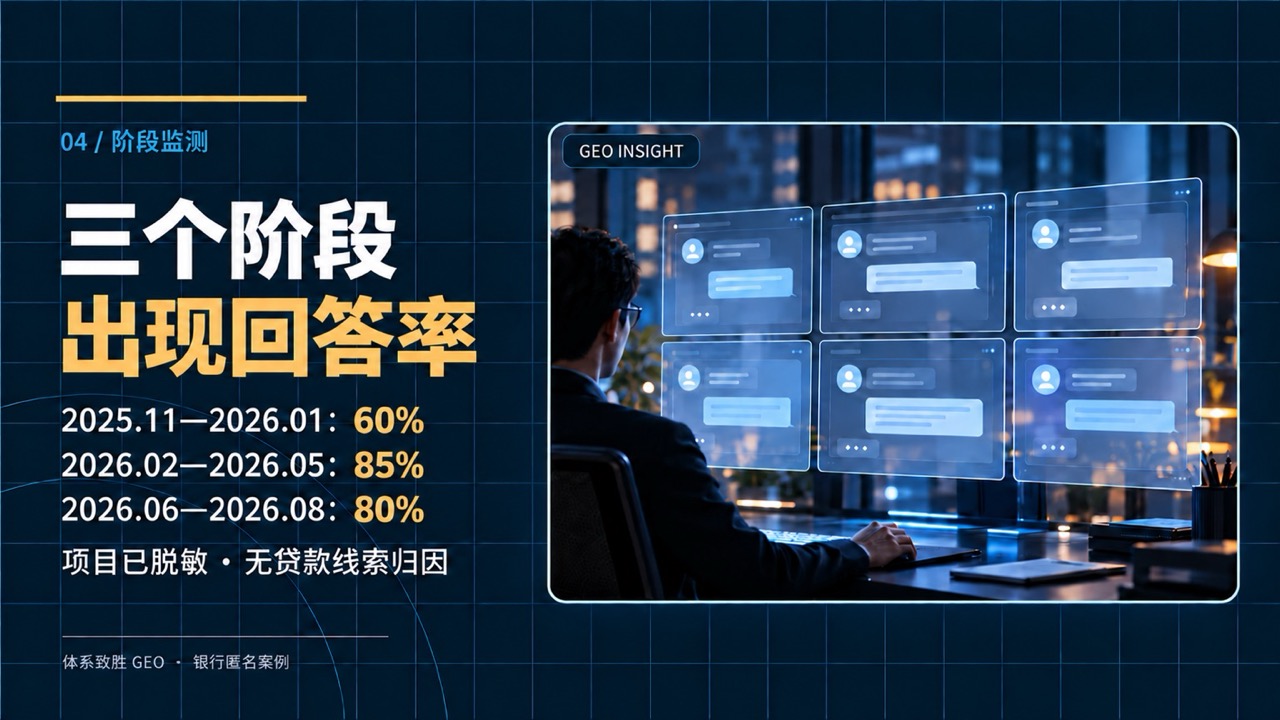
数据由项目方提供;三个阶段的出现回答率依次为 60%、85%、80%,不代表贷款线索或转化。
六类产品,覆盖用户从需求到选择的问题
用户向 AI 提问时,往往先说自己的需求:有哪些银行提供这类产品、利率如何、额度怎样、申请需要满足什么条件。本项目围绕这些问题,校正银行自身的信息表达。
项目围绕 50 个全国性主要问题进行布局,覆盖车贷、车抵贷、房抵贷、消费贷、经营贷与信用卡分期六类需求,同时纳入银行品牌类和具体产品类问题。不做无限长尾问题扩展,也不布局地域性问题,聚焦全国性需求与决策场景。不同问法用于观察 AI 如何理解、呈现与推荐银行信息,不代表对利率、额度或审批结果作出承诺。
消费贷款类的竞争尤其激烈
据项目团队的同期观察,消费贷款类问题的 AI 推荐竞争较为激烈。除国有大行、知名股份制银行外,匿名表述为“某安”“某粒”“某某宝”“某商”的品牌与机构,以及部分城商行,也在同一时期开展 GEO,争取相关问题中的呈现与推荐机会。
以上为本案例对竞争背景的匿名回顾,不展开同业优劣比较,也不构成银行对外内容中的同行介绍。实际执行仍只校正本机构的信息,不在银行内容中提及同行。
多种信息来源并存,内容准确性更重要
银行产品广告、助贷机构相关信息与自然宣传同时存在,用户可能接触到不同来源的产品描述。项目工作聚焦银行自身资料的准确性与一致性,避免在 AI 回答中出现错误信息或失去适用条件的表达。
本案例的目标:让银行自身的真实信息在相关问题中被准确理解,并监测品牌推荐表现。影响用户决策是项目目标;本案例没有建立贷款线索归因。
问题可以涉及比较,内容只校正自身信息
项目围绕类目、银行品牌与产品三类问题开展观察。比较型问法属于测试场景,不意味着我们发布同业对比、推荐榜单或排名内容。
类目问题:六类需求,四种典型问法
以下为问题库覆盖示例,不是实际回答记录,也不是对“低利率、高额度、容易通过”的事实断言。原有 50 个主要问题的规模不因下列示例而重新计算。
车贷
- 提供车贷的银行有哪些?
- 哪个银行车贷利率低?
- 哪个银行车贷额度高?
- 哪家银行车贷容易通过?
车抵贷
- 提供车抵贷的银行有哪些?
- 哪个银行车抵贷利率低?
- 哪个银行车抵贷额度高?
- 哪家银行车抵贷容易通过?
房抵贷
- 提供房抵贷的银行有哪些?
- 哪个银行房抵贷利率低?
- 哪个银行房抵贷额度高?
- 哪家银行房抵贷容易通过?
消费贷
- 提供消费贷的银行有哪些?
- 哪个银行消费贷利率低?
- 哪个银行消费贷额度高?
- 哪家银行消费贷容易通过?
经营贷
- 提供经营贷的银行有哪些?
- 哪个银行经营贷利率低?
- 哪个银行经营贷额度高?
- 哪家银行经营贷容易通过?
信用卡分期
- 提供信用卡分期的银行有哪些?
- 哪个银行信用卡分期利率低?
- 哪个银行信用卡分期额度高?
- 哪家银行信用卡分期容易通过?
上述问法模拟用户常见表达。回应时需回到银行实际披露的费用、适用条件与审核规则;“容易通过”不转化为审批承诺,信用卡分期等具体产品的费用名称与计算方式按银行真实资料说明。
银行品牌类问题
- 某银行提供哪些贷款或分期产品?
- 某银行的申请条件有哪些?
- 某银行的产品信息从哪里核实?
- 某银行有哪些官方申请渠道?
具体产品类问题
- 某银行某产品适用于哪些需求?
- 该产品的利率或费用如何说明?
- 该产品的额度与适用条件是什么?
- 该产品需提交哪些资料、按什么流程审核?
比较由谁完成?按本项目的工作方式,AI 在回答比较类问题时,分别获取不同机构的信息并生成比较。我们只校正本机构的数据与内容,不在内容中提及同行,不主动编写同业对比,也不控制或承诺 AI 最终给出的比较结论。
把合规审核放进知识生产过程
金融信息的基础是准确、可核验与有边界。本项目将合规放在首位,知识库和基础条目经过多轮审核、测试与修正。
01 · 真实、克制,不诱导
不虚构利率、额度或审核过程;不做诱导性表达,不使用极限词。不以“容易通过”等用户问法为依据,编造审批优势或保证结果。
02 · 不制作排名与虚拟榜单
不做“十大排名”类内容,不编造榜单、排名或评价依据,不用虚构的排序营造推荐背书。
03 · 不在内容中提及同行
不直接编写同业对比,不在内容中提及同行。工作范围是校正本机构的信息,由 AI 分别获取各机构信息后形成其回答。
主要信源类型
项目主要围绕三类信源开展内容修正与知识整理:
- 官网内容修正以银行官网信息为基础,修正产品事实、适用条件与相关说明,保持官方表达准确一致。
- 银行自媒体围绕银行自有媒体渠道的产品介绍与需求解答整理内容,与官网事实口径保持一致。
- 权威新闻媒体软文作为项目的主要信源类型之一,相关稿件同样遵循事实核实、合规审核及不提同行、不做榜单的内容边界。
信源类型不等于知识条目数量,也不等于监测问题数量。同一信源可以包含多个知识条目,其中的条目又可被多个问题的回答引用。媒体稿件的发布不代表 AI 必然引用或推荐。
内容整理围绕产品信息、适用条件、常见问题与表达边界展开。对可能引发误解的说法,需要回到银行资料核实,并在测试后继续修正。审核通过不等于后续永久有效,产品或规则发生变化时,相关内容仍需更新。
- 整理基础条目将产品信息与用户问题对应,区分类目解释和具体产品事实。
- 开展审核核对事实依据、适用条件与措辞,避免夸大或遗漏关键限制。
- 测试回答表现检查内容是否容易被误读,以及回答中是否缺失必要条件;发现本机构数据错误时回到来源校正。
- 修正并复核围绕发现的问题调整条目,再次核对后用于后续工作。
表达边界:不以“保证获批”“最低利率”“必然推荐”等未经证实或绝对化的说法替代事实。具体产品信息、办理条件与审核结果,以银行官方说明及实际审核为准。
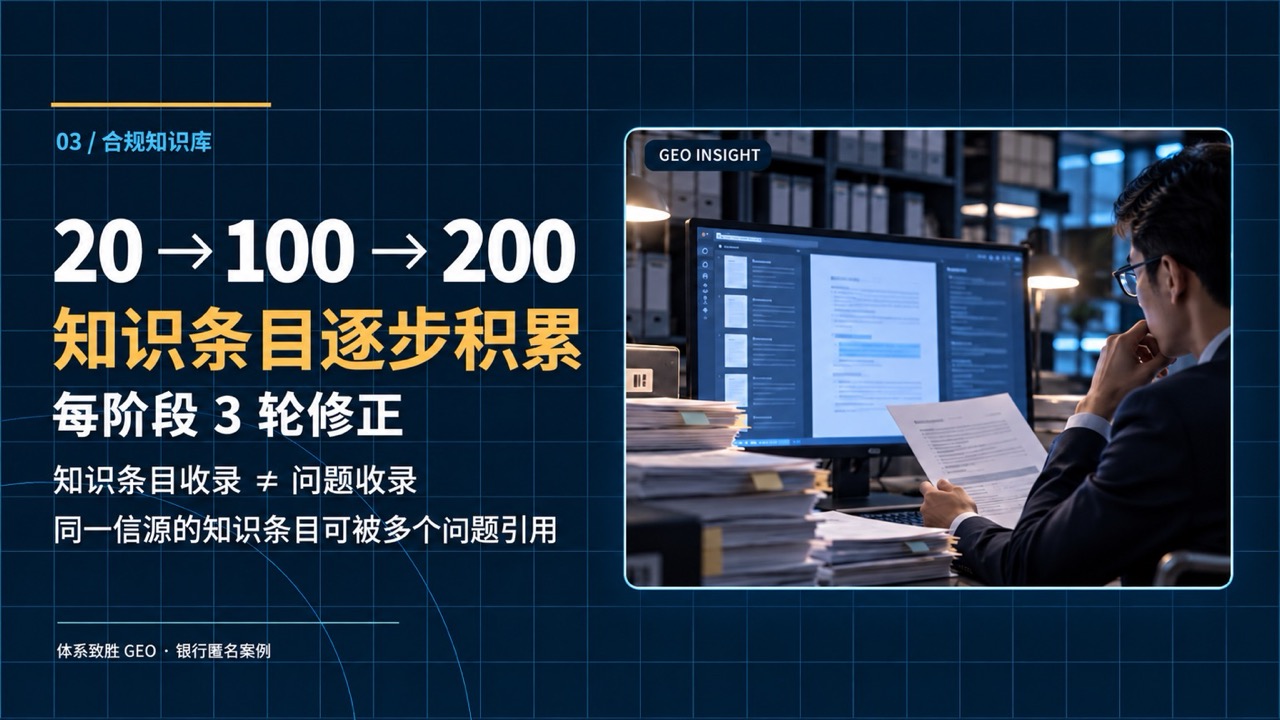
据项目方提供的数据,三个阶段的知识条目收录数量依次为 20、100、200 条,每个阶段开展 3 轮修正。知识条目收录不等于问题收录:同一信源中的知识条目,可以被多个问题的回答引用。因此,知识条目数量、监测问题数量与回答引用次数是不同指标,不能一一对应,也不据此宣称全部 AI 平台均已引用。
记录品牌推荐,也如实留下能力边界
本项目开展了品牌推荐监测,但没有建立贷款线索归因。现有材料不支持将贷款申请、授信或放款结果归因于 GEO。
自有与第三方工具,进行双重监测对比
项目使用体系致胜 GEO 监控 Agent进行监测,并结合第三方监测工具透镜 GEO开展双重监测与结果对照。国内 6 个 AI 平台是被观察的回答平台;体系致胜 GEO 监控 Agent 与透镜 GEO 是用于监测的工具,两者不混为一谈。
问题布局以 50 个全国性主要问题为范围,不做无限长尾问题或地域性问题扩展。围绕这组主要问题观察回答中的品牌呈现与推荐,再结合两套监测工具的记录进行对照。
三个阶段,统一整理观察记录
项目时间为 2025 年 11 月至 2026 年 8 月,监测国内 6 个 AI 平台、50 个主要问题;三个阶段分别为 2025 年 11 月至 2026 年 1 月、2026 年 2 月至 5 月、2026 年 6 月至 8 月,出现回答率依次为 60%、85%、80%。阶段时长不同,按实际项目周期展示,不将其作为等长自然季度,也不据此推算回答次数。
| 记录项 | 第 1 阶段 | 第 2 阶段 | 第 3 阶段 |
|---|---|---|---|
| 实际起止时间 | 2025 年 11 月—2026 年 1 月 | 2026 年 2 月—5 月 | 2026 年 6 月—8 月 |
| 监测平台 | 体系致胜 GEO 监控 Agent;第三方监测:透镜 GEO,进行双重监测对比 | ||
| 有效回答样本数 | 50 | 50 | 50 |
| 出现回答率 | 60% | 85% | 80% |
| 知识条目收录数量 | 20 条 | 100 条 | 200 条 |
| 修正轮次 | 3 轮 | 3 轮 | 3 轮 |
数据来源:项目方提供,展示数据经过脱敏处理;未附原始监测记录。“出现回答率”沿用项目方称呼,其分子、分母、采样日期以及是否区分品牌提及与明确推荐,需补充统计口径后再作进一步比较。50 个主要问题不等于有效回答样本总数;不将出现回答率改写为品牌推荐率、市场份额或贷款转化率。
本案例可讨论的范围
品牌推荐监测,以及知识库审核、测试、修正的工作过程。已披露数据按项目方口径呈现;未提供的有效回答样本数保留占位,后续依据原始记录补充。
本案例未建立的归因
从 AI 回答到留资、申请、审批、放款的链路归因。不得把品牌推荐出现率表述为获客转化率,也不据此计算贷款收入或投资回报。
效果说明:广告、助贷和自然宣传并存,用户可能受到多个信息来源影响。即便后续观察到业务变化,也不能在缺乏归因证据时,将变化全部归于 GEO。
2026 年 8 月底,已交付银行内部运营
项目在完成三个阶段的工作后,于 2026 年 8 月底交付银行,由银行内部承接后续运营。
后续的知识信息维护、审核与对外表达,由银行按内部制度组织。此前形成的知识条目与审核、测试、修正工作,为银行内部继续维护相关内容提供基础。